La plupart des entreprises françaises qui utilisent sérieusement l'IA générative finissent par rencontrer le même problème. Un seul modèle frontière traite toutes les demandes, la facture augmente chaque mois, et le DPO demande pourquoi des e-mails clients quittent l'Union européenne pour une question qu'un modèle bien plus petit aurait pu traiter. Une architecture LLM hybride règle ce problème : au lieu de choisir un modèle unique pour toute l'entreprise, vous envoyez chaque requête vers le modèle adapté à sa sensibilité, à sa difficulté et à votre budget. Ce guide explique comment fonctionne le routage, ce qui a changé en 2026 et comment le mettre en place sans lancer un projet de recherche.
LLM hybride et routage : de quoi parle-t-on ?
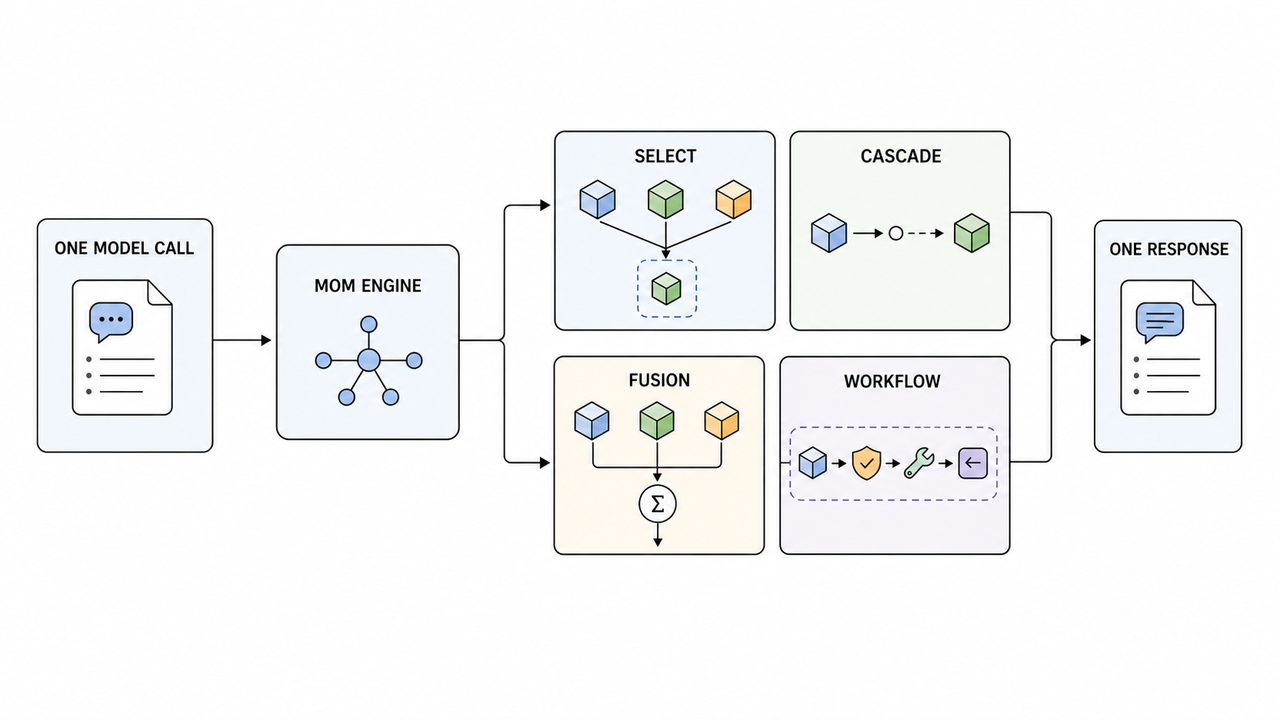
Un routeur se place entre vos applications et vos modèles de langage. Votre assistant CRM, votre chatbot de support ou votre agent IA interne envoie un appel d'API ordinaire. Le routeur analyse la requête, puis décide quel modèle y répond : un petit modèle open source (à poids ouverts) sur vos propres serveurs, un modèle ouvert hébergé en Europe, ou une API frontière comme Claude, GPT ou Gemini.
Le projet open source vLLM Semantic Router (en anglais) illustre bien ce principe. Sa version 0.2, publiée en mars 2026, extrait des signaux de chaque requête (intention, complexité, langue, contexte), les compare à des règles de routage, puis choisit un modèle avec un algorithme qui arbitre entre qualité, latence et coût. L'une des options, AutoMix, commence par un modèle moins cher et n'escalade que si nécessaire. La détection des tentatives de contournement (jailbreak) et des données personnelles fait partie du chemin de routage principal, et non d'un module optionnel.
En juillet 2026, le projet est allé plus loin en décrivant une approche Mixture-of-Models (en anglais) : plusieurs modèles indépendants, avec des éditeurs, des licences et du matériel différents, exposés derrière une interface unique et stable. Le point clé pour une entreprise européenne est explicite : une contrainte de confidentialité peut exclure un modèle distant plus performant, et le système suit alors une solution de repli déclarée au lieu d'envoyer discrètement les données dans le cloud.
Pourquoi 2026 facilite l'IA hybride pour les entreprises européennes
Il y a deux ans, une architecture hybride signifiait héberger soi-même tout ce que l'on ne voulait pas envoyer à une API américaine. Ce n'est plus la seule option.
Traitement régional chez un acteur européen : Mistral a rendu ses points de terminaison régionaux disponibles en août 2026, ce qui permet de choisir si l'inférence s'exécute en Europe ou aux États-Unis. Mistral précise que des transferts limités vers des sous-traitants hors de la région restent possibles : lisez son Trust Center avant d'écrire « UE uniquement » dans un contrat.
Des modèles ouverts hébergés par un tiers : dans la même annonce, Mistral indique qu'il hébergera des modèles ouverts d'autres éditeurs sur son infrastructure, à commencer par GLM-5.2 de Z.ai, avec les mêmes contrôles régionaux que ses propres modèles. Vous utilisez un modèle à poids ouverts sans acheter de GPU.
Un calendrier réglementaire plus lisible : selon la page de la Commission européenne sur l'AI Act (en anglais), les obligations des modèles d'IA à usage général s'appliquent depuis le 2 août 2025, les obligations de transparence depuis août 2026, et les obligations pour les systèmes à haut risque de l'annexe III (emploi, éducation, etc.) ont été reportées au 2 décembre 2027 par l'Omnibus IA. Un routeur qui journalise quel modèle a traité quelle requête simplifie fortement cette documentation.
Si vous hésitez encore à héberger vous-même un modèle, commencez par notre guide de décision LLM auto-hébergé ou API frontière. Le routage est l'étape suivante, une fois admis que la bonne réponse est souvent « les deux ».
Répartir le trafic : une politique de routage défendable
Une politique de routage est un court ensemble de règles lisible par la DSI, le juridique et les métiers. Commencez avec trois niveaux et résistez à l'envie d'en ajouter.
Niveau 1, modèle open source local ou hébergé en Europe. Choisissez-le si :
- la requête contient des données personnelles, RH, de santé ou des clauses contractuelles qui ne doivent pas sortir de votre périmètre ;
- la tâche est répétitive et bien délimitée : classification, extraction de champs, résumé d'un compte rendu d'appel, catégorisation de tickets ;
- le volume est élevé et quelques points de qualité ne changent pas le résultat métier.
Niveau 2, API frontière via une région européenne ou un contrat entreprise. Choisissez-la si :
- la tâche exige un raisonnement poussé, de longs documents ou l'usage de plusieurs outils en séquence ;
- les données ont été minimisées ou pseudonymisées par le routeur avant de sortir ;
- une erreur coûte assez cher pour justifier le surcoût par requête.
Niveau 3, refuser ou transmettre à un humain. Choisissez-le si le routeur détecte une tentative de contournement, une demande hors périmètre ou des données sensibles dans un flux qui n'est validé pour aucun modèle.
Rédigez la politique avant de choisir les outils. Les mêmes règles peuvent être mises en œuvre avec vLLM Semantic Router, une passerelle IA commerciale ou une simple couche de règles dans votre plateforme d'intégration.
Que faire maintenant : un déploiement en six étapes
- Recensez vos appels IA. Exportez un mois d'utilisation par outil et par clé d'API : quelle application, quel modèle, combien de requêtes, quelles catégories de données. La plupart des entreprises découvrent que deux ou trois flux concentrent l'essentiel du coût.
- Classez chaque flux selon sa sensibilité et sa difficulté. Deux axes suffisent : « contient des données personnelles, oui ou non » et « nécessite un raisonnement de niveau frontière, oui ou non ».
- Constituez un jeu d'évaluation par flux. Cinquante à cent exemples réels et anonymisés, avec les réponses attendues. Testez-les sur le modèle ouvert candidat et sur votre modèle frontière actuel. Notre guide pour évaluer un workflow IA avant de le déployer explique comment les noter.
- Commencez par un flux et une solution de repli. Orientez le flux le plus simple et le plus volumineux vers le modèle ouvert, gardez le modèle frontière comme voie d'escalade et journalisez chaque décision de routage.
- Placez les garde-fous dans le routeur, pas dans chaque application. Détection des données personnelles, contrôle des injections de prompt et budgets par équipe se gèrent à un seul endroit pour profiter à toutes les applications.
- Faites une revue mensuelle. Comparez le coût par requête, le taux d'escalade et les réclamations des utilisateurs. De nouveaux modèles ouverts sortent toutes les quelques semaines ; un routeur permet d'en changer sans toucher aux applications.
Les compromis à garder en tête
Le routage a un coût. Vous ajoutez un composant à superviser, sécuriser et versionner. Une requête mal classée peut envoyer des données sensibles au mauvais modèle ou produire une réponse faible là où la qualité comptait : c'est pourquoi l'évaluation et les journaux passent en premier. Héberger vos propres modèles ouverts implique aussi de gérer les mises à jour, la capacité et les correctifs de sécurité ; un hébergeur européen supprime ce travail, mais ajoute un contrat à examiner.
Pour la plupart des ETI et PME françaises, l'objectif réaliste reste modeste : un routeur, deux ou trois modèles, une politique écrite et une revue mensuelle. Cela suffit généralement à reprendre la main sur les coûts et sur la protection des données.
Conclusion
La question n'est plus « modèle open source ou modèle frontière ? », mais « quelle requête va où, et pouvons-nous le prouver ? ». Une architecture LLM hybride vous donne ce contrôle tout en gardant l'accès aux meilleurs modèles quand vous en avez besoin. Pour cartographier vos flux IA et rédiger une politique de routage, notre offre stratégie et feuille de route IA commence précisément là, et notre équipe implémentation IA peut construire et évaluer le routeur avec votre DSI.